


【2026年10月】Gemini 4 Argonの性能を比較|GPT-6との違い・100万トークン・使い方
公式の性能比較と4枚の参考画面で、得意分野・使い方・限界を確認します。
Googleは2026年10月13日、Gemini 4 Argon(ジェミニ4・アルゴン)のGeminiアプリでの提供を発表しました。9月30日の初回発表・限定提供と、今回の提供拡大は区別して捉えると分かりやすくなります。[1][7]
- 専門業務・自動化の評価では高い成績。ただし、すべての開発課題で首位ではありません。
- 約100万トークンは入力・推論・出力で使う共通の枠。通常チャットの出力量を保証する数字ではありません。
- 画面の見やすさと回答の正確さは別。スクリーンショットは操作・回答形式の参考として紹介します。
1.GPT-6・Claudeとの性能比較
ベンチマークとは、決められた課題をAIに解かせて能力を測るテストです。以下はGoogle DeepMindの2026年10月版モデルカードに掲載された数値です。当サイトが同じ条件で3モデルを動かして測定した結果ではありません。[2]
| 評価項目 | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index(知識業務) | 68.9% | 63.1% | 67.0% |
| AutomationBench(自動化) | 51.3% | 41.4% | 42.5% |
| DeepSWE v1.1(開発) | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2(開発) | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0(端末を使う作業) | 57.4% | 58.2% | 66.4% |
| LABBench 2(科学分野) | 88.8% | 85.4% | 73.1% |
出典:Google DeepMind「Gemini 4 Argon Model Card」。比較対象の一部を抜粋。各行は別の課題・採点尺度で、行をまたいだ単純比較や平均による総合順位は示していません。
専門業務・自動化は注目分野
この3モデルの比較では、ArgonはVals Index、AutomationBench、DeepSWE、LABBench 2で高い数値を示しています。一方、FrontierSWEではGPT-6 Astra、Terminal-benchではClaude Opus 5.5が上回ります。「どんな用途でもArgonが最強」とは読めない結果です。
テスト条件も確認しよう
公式の評価方法では、Argonは特記のない限りAPIの最高思考設定で評価されています。他社の数値には提供元の公表値や公開ランキングの結果が含まれ、一部はGoogle側で測定されています。すべてが同一環境の直接対決ではありません。[3]
普段のモデル選びでは、自分の資料や質問で「間違いの少なさ」「修正の手間」「待ち時間」を比べると判断しやすくなります。日本語の記事制作がどれだけ速くなるかは、この表だけでは分かりません。
2.約100万トークンで何が変わる?
トークンは、AIが文章などを処理する際の単位です。文字数やページ数とは一対一で対応しません。大量の資料を渡せる容量と、その内容を正確に読み取れる能力も別です。
| APIの項目 | 公式仕様 |
|---|---|
| 共通コンテキスト枠 | 1,048,576トークン |
| 通常の同期処理の最大出力 | 65,536トークン |
| Long Decode | バックグラウンド実行で最大約100万トークンまで対応 |
| 入力/出力 | 文章・画像・動画・音声・PDF / 文章 |
| 推論レベル | low・medium・high |
APIの仕様では、入力と推論、出力が共通の枠を使います。100万トークン分の資料を読み込み、さらに別枠で100万トークンを出せるわけではありません。長文出力にはLong Decodeとバックグラウンド実行の設定が必要で、Geminiアプリの通常チャットで同じ上限が使えることは意味しません。[4][5]
活用例:複数資料を突き合わせる
例えば、仕様書・議事録・変更履歴を渡し、説明の食い違いを探す使い方です。コードの修正では、関連ファイルを参照しながら修正案と確認項目を考えさせる用途が考えられます。これは活用例であり、今回その作業を実測した結果ではありません。
長い資料では「根拠のページや節も示して」「見つからなければ不明と書いて」と条件を加え、重要な箇所を自分で照合しましょう。
3.モデル選択と推論レベルの見方
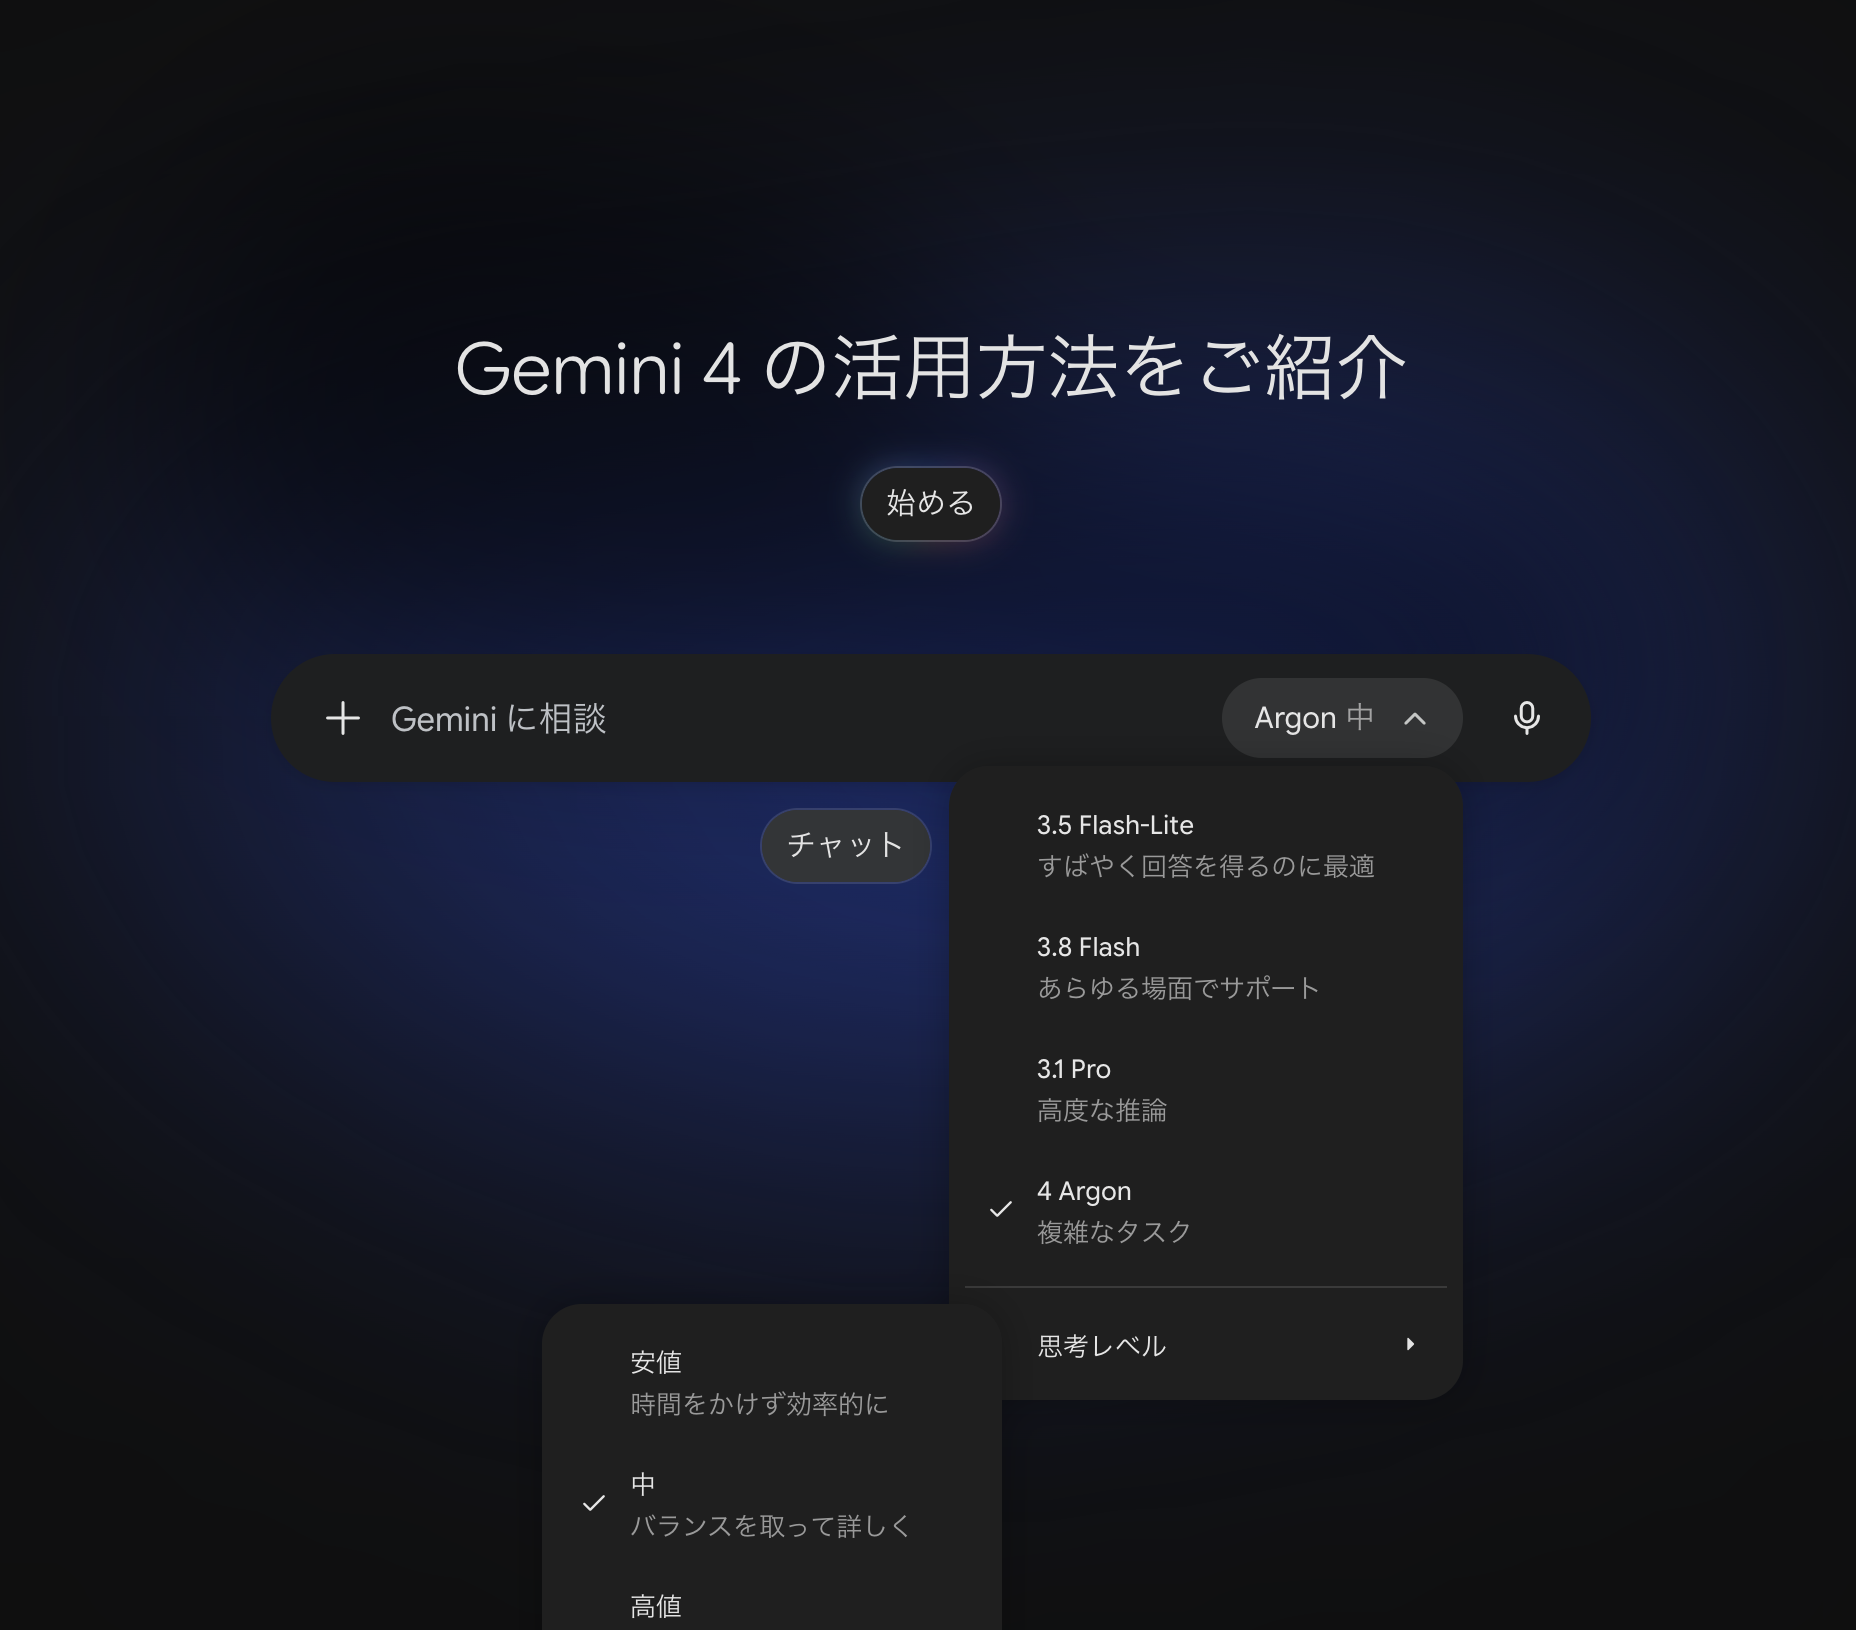
この画像では「4 Argon」が選択され、思考レベルの「中」にチェックがあります。「思考レベル」という項目と説明文から、表示の「安値」「中」「高値」は料金表ではなく、考える処理の強さを選ぶ項目として読めます。APIの公式仕様にもlow・medium・highの3段階があります。表示名や選択肢は利用環境で変わる可能性があります。[4]
| 設定 | 使い分けの目安 |
|---|---|
| low(画面では「安値」) | 短い文章の修正など、まず速さを重視して試す |
| medium(「中」) | 比較・資料整理などでバランスを見る |
| high(「高値」) | 難しい分析や開発課題で、待ち時間と結果を比較する |
上の使い分けは編集部の提案です。highにすれば必ず正解になるとは限らず、処理時間や利用量とのバランスを見て選びます。
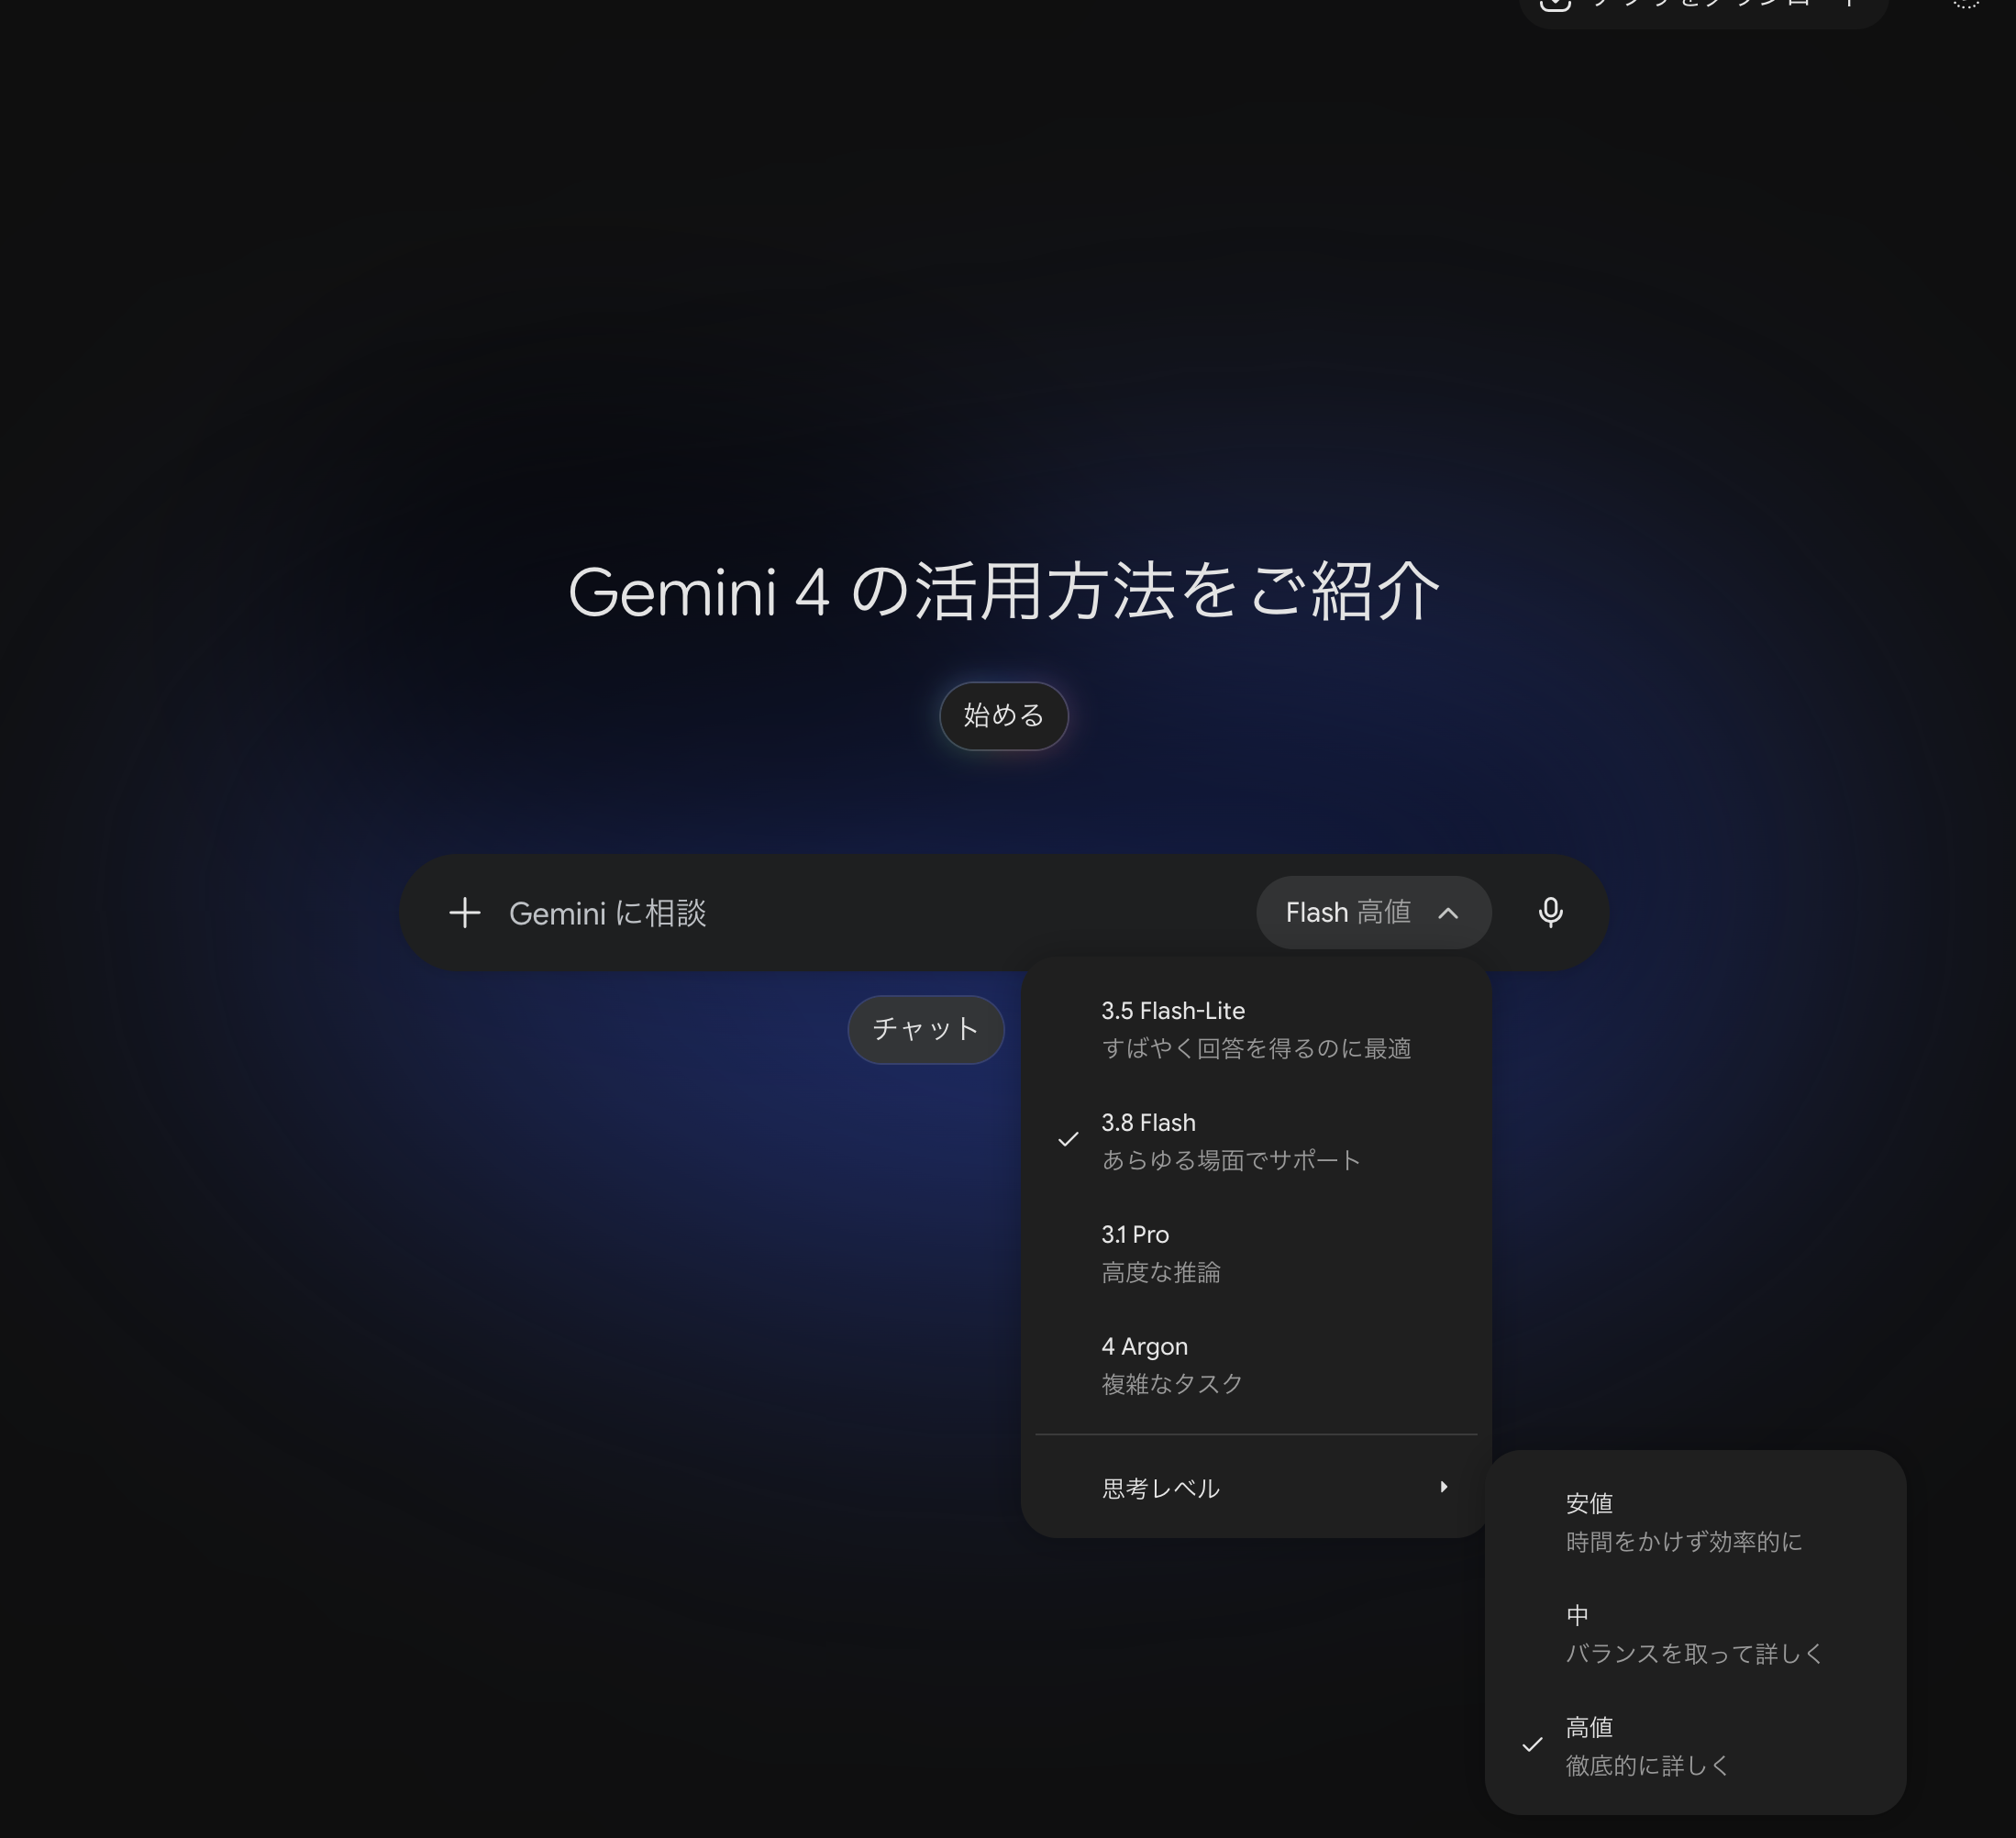
4つのモデル名が並ぶ画像でも、チェック位置によって実際の選択モデルは異なります。比較するときは、質問文だけでなくモデル名・思考設定・検索の有無も記録しておきましょう。
4.調査への使い方を添付画面で確認
Windowsの更新情報を整理する例
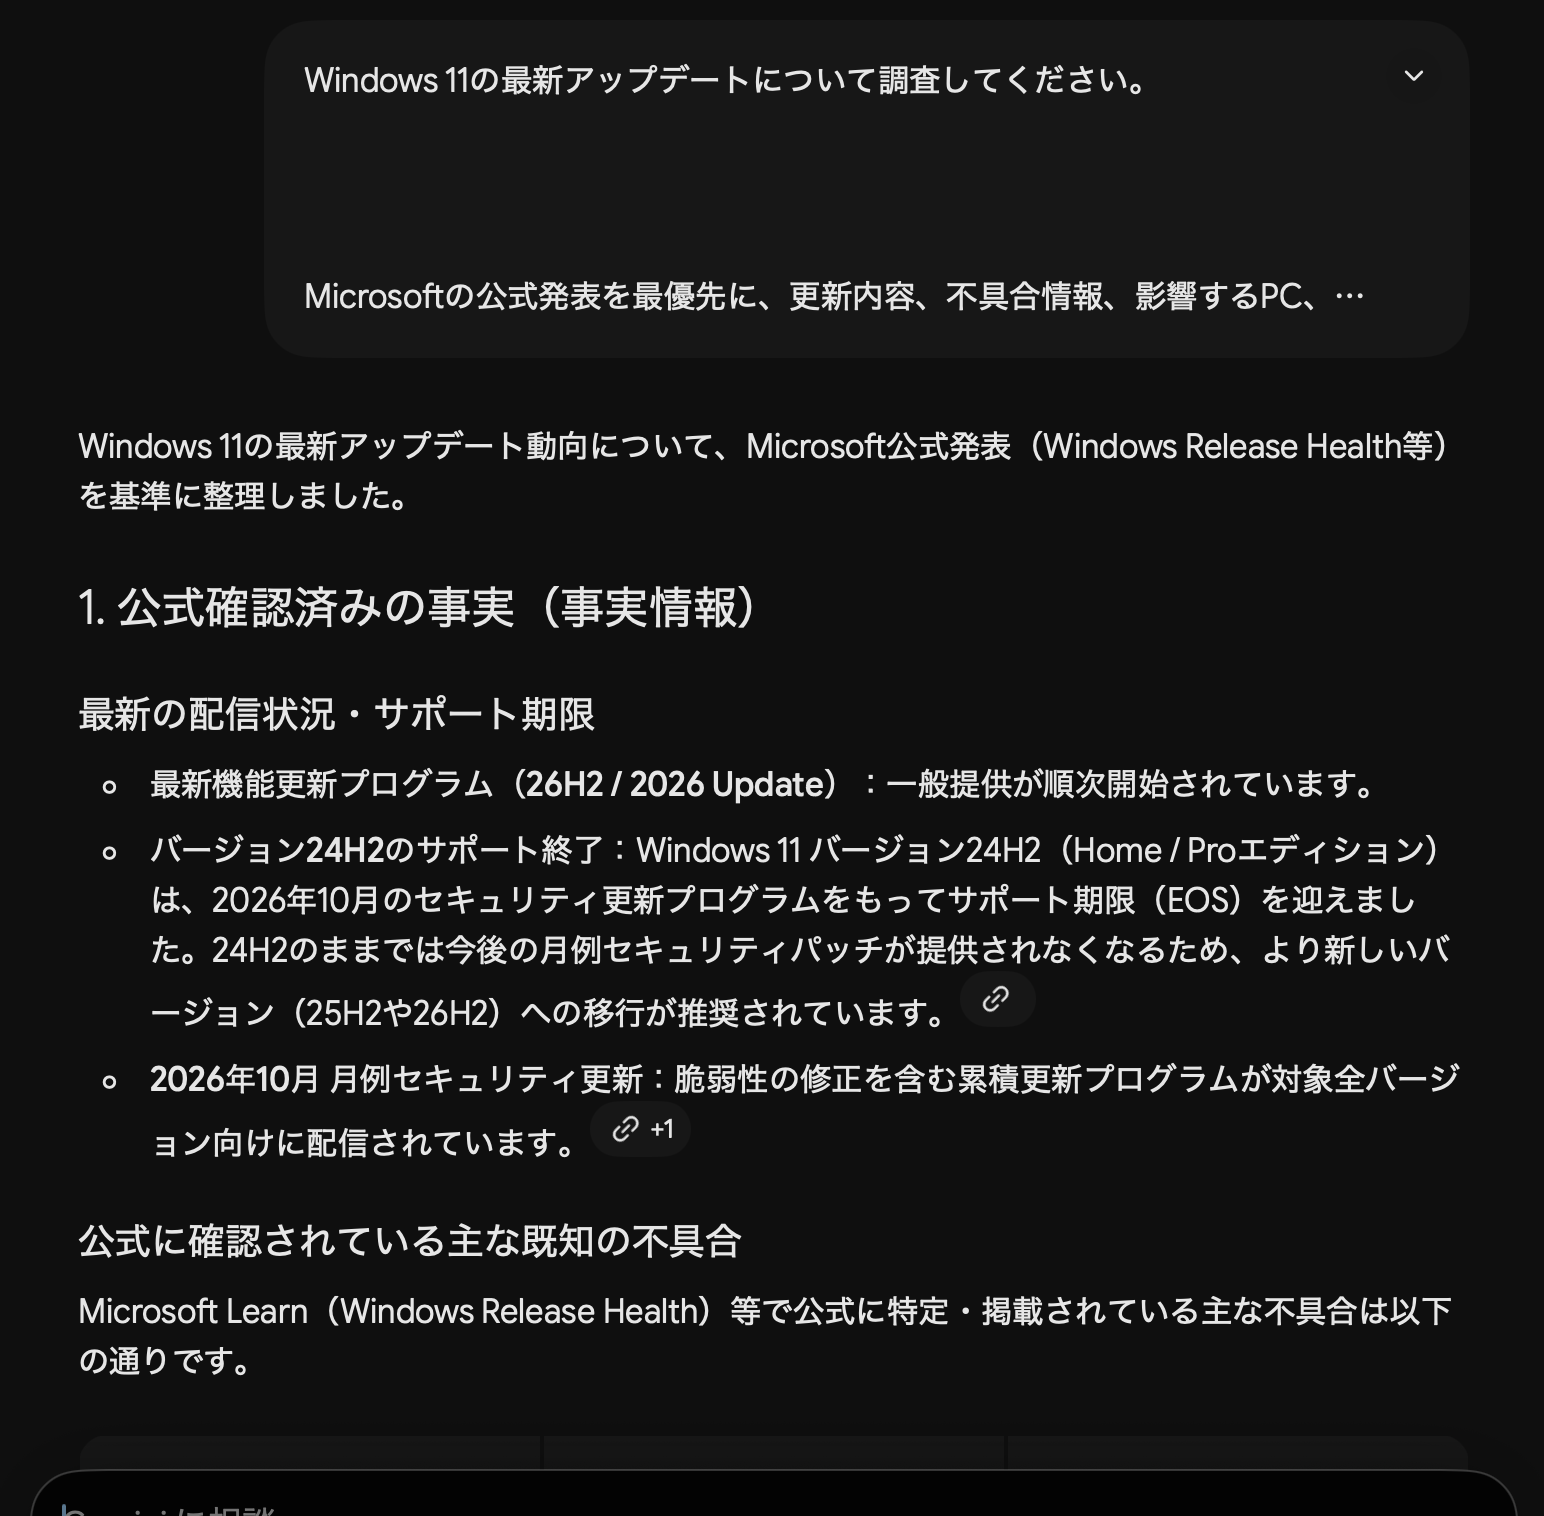
この画面では、配信状況・サポート期限・既知の不具合を分けた回答が見えます。調べる項目を整理する参考になります。ただし、画像には使用モデルや設定の確認に必要な情報がすべて写っていないため、Argonの正答率を示す実測例とは扱いません。
記事に利用する際は、リンク先の公式ページを開き、発表日・対象バージョン・例外条件を確認する作業が必要です。
「事実」と「推測」を分ける例
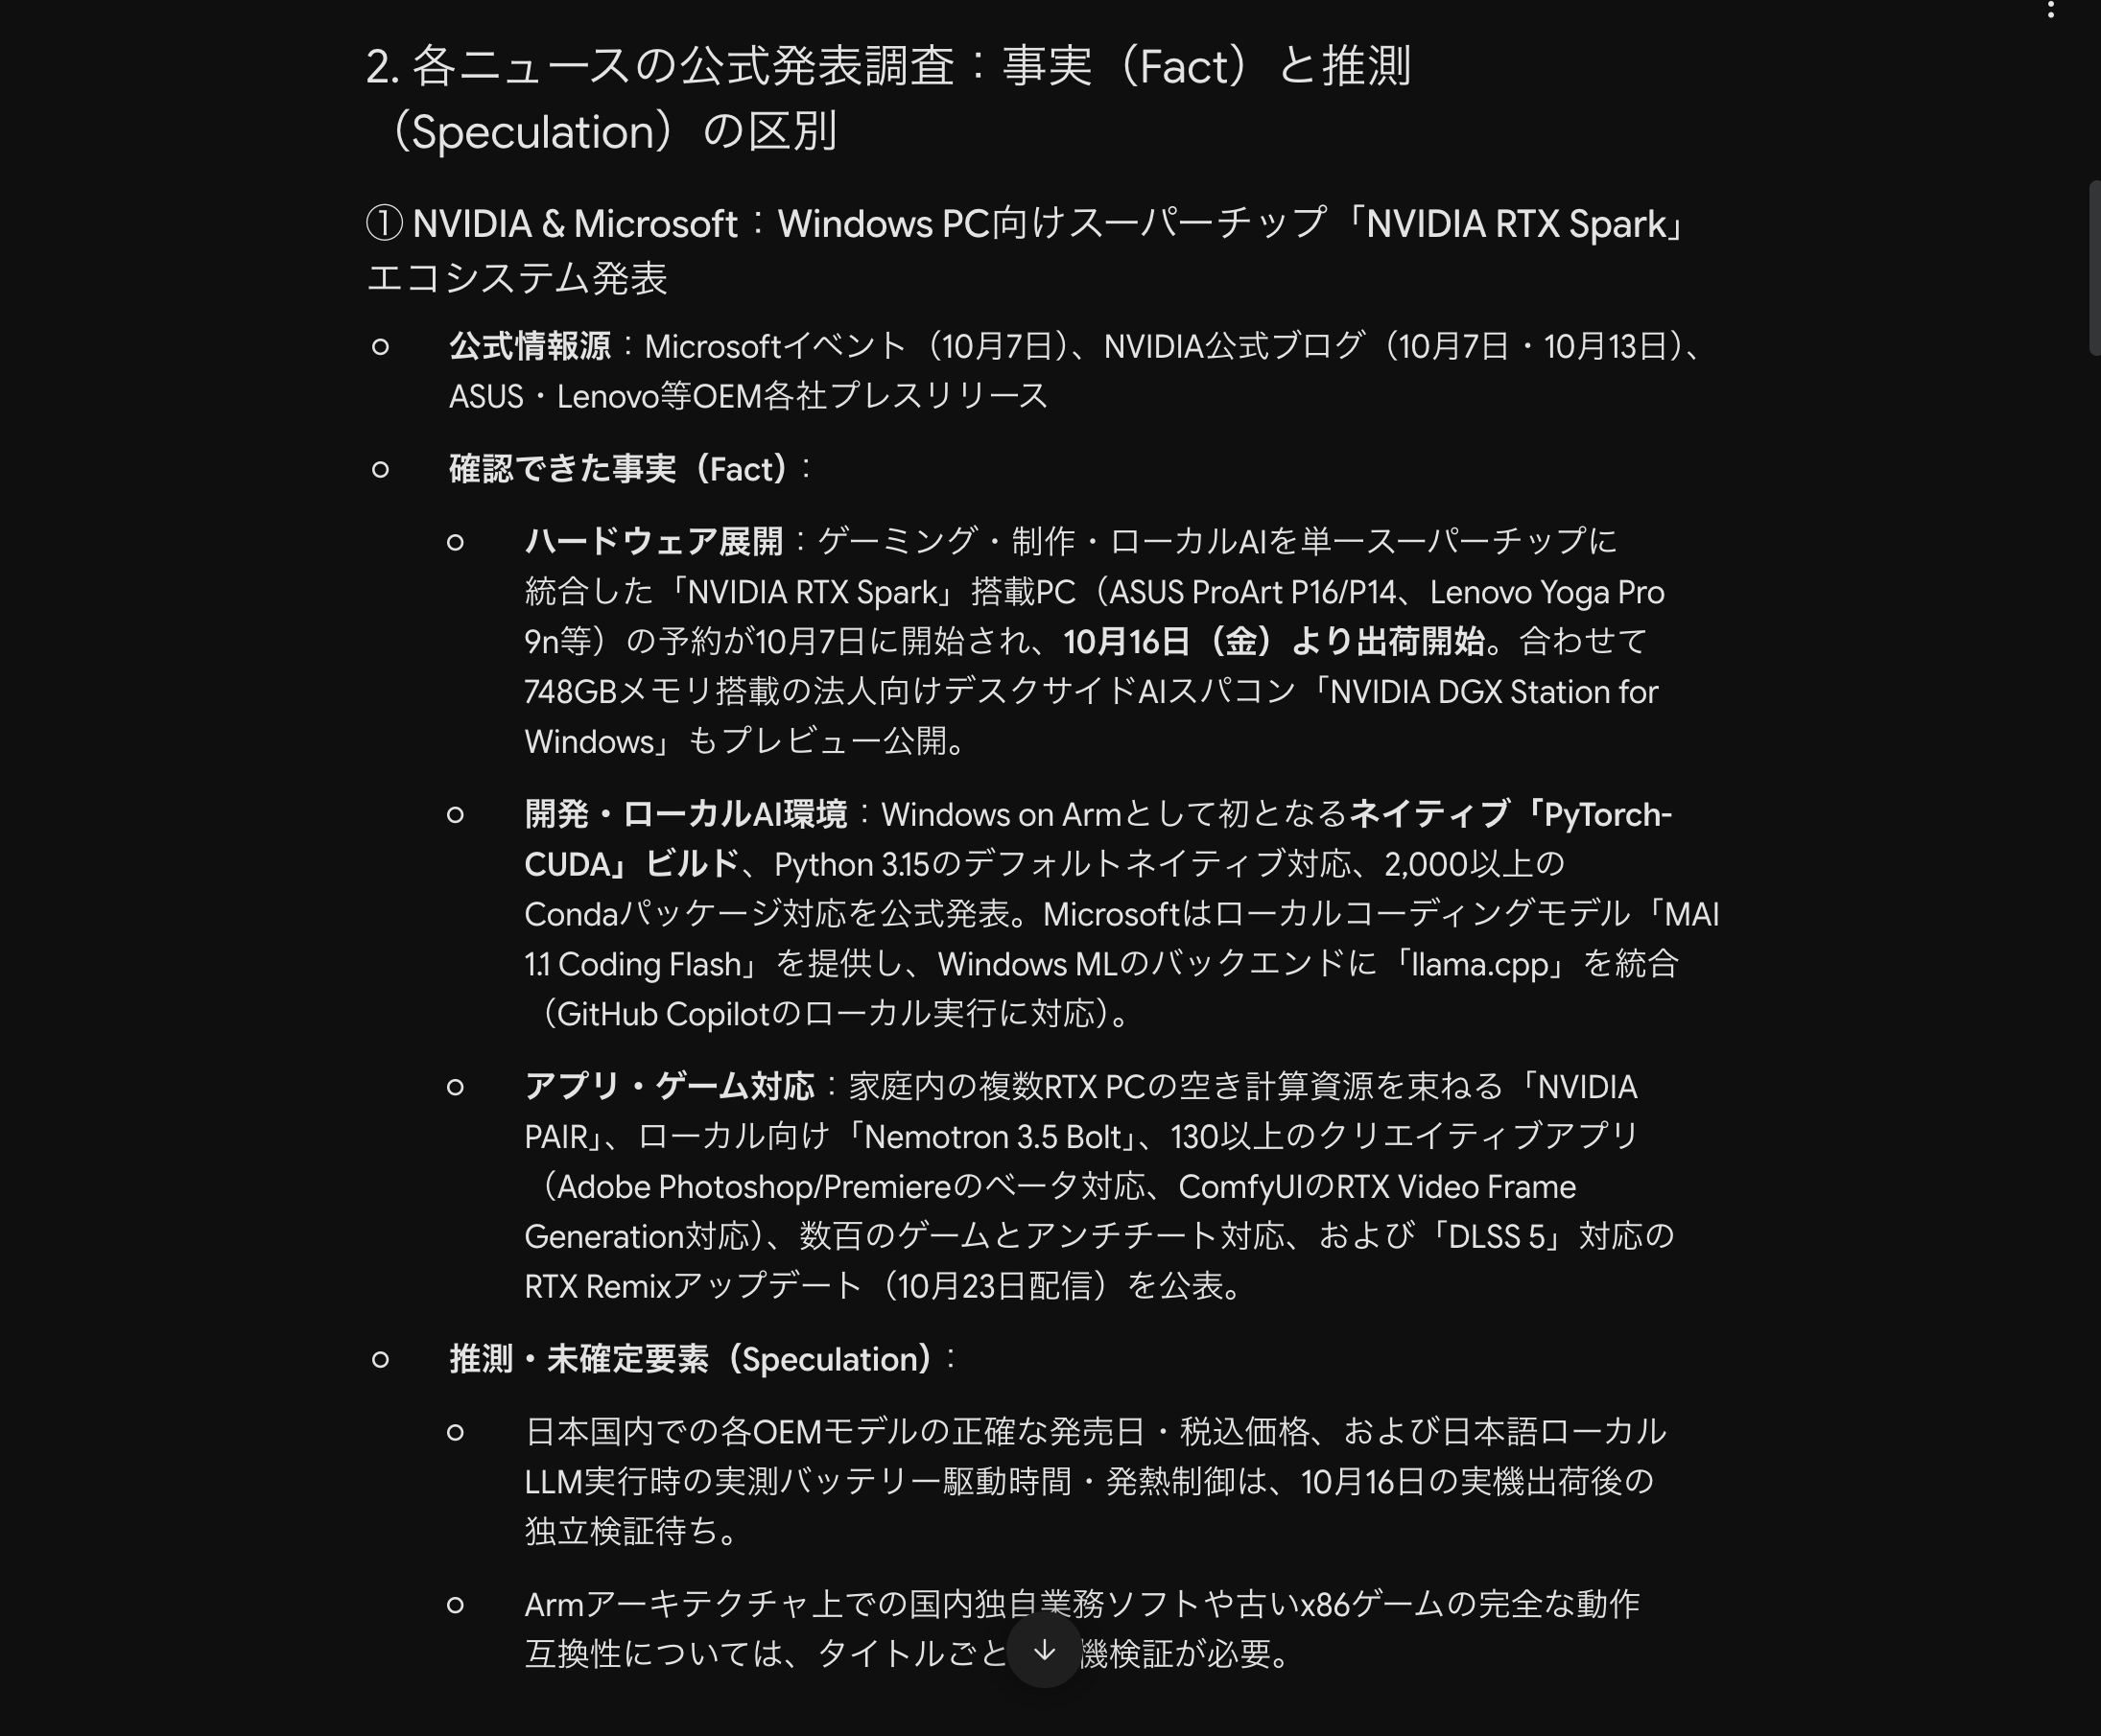
見出しを分けると、追加調査が必要な箇所を探しやすくなります。ただし、AIが「確認できた事実」と書いたこと自体は証拠になりません。原資料と照らし合わせて初めて、記事に使える情報か判断できます。
「このテーマを公式資料から調べ、確認できた内容・未確認の内容・あなたの分析を分けてください。各項目に出典URLと発表日を付け、根拠がない数値は補わないでください。」
このような調査・整理・下書きを複数工程で進めるのが、AIエージェントの活用例です。GoogleはGeminiアプリのタスク機能と外部アプリ連携も案内しています。実際の操作範囲は接続先や付与した権限によって変わるため、資料を読む権限と、投稿・編集する権限を区別して使いましょう。[1]
5.料金と始め方
Googleの10月13日の案内では、GeminiアプリのArgonとタスク機能はGoogle AI Pro・Ultraの契約者向けです。APIをプログラムから呼び出す料金とは分けて考えてください。[1]
| API料金(100万トークン当たり) | 2026年11月30日まで | 2026年12月1日以降 |
|---|---|---|
| 入力 | 2米ドル | 4米ドル |
| 出力(推論トークンを含む) | 10米ドル | 20米ドル |
上の表は導入価格とその後の公表価格で、アプリの月額料金ではありません。APIの無料枠はなく、内部推論も出力側の料金に含まれます。APIの利用条件はアプリのPro契約とは異なります。最新条件は公式料金ページを確認してください。[5][6]
- Gemini公式サイトを開き、利用するGoogleアカウントでログインする。
- モデル選択欄で「4 Argon」を選ぶ。表示されない場合は契約とアカウントを確認する。
- 選択できる場合は思考レベルを設定し、まず短い依頼から試す。
- 回答に含まれる数値やリンクを確認し、必要なら条件を追加して聞き直す。
6.よくある質問
Gemini 4 ArgonはGPT-6より高性能ですか?
評価項目によります。掲載した公式比較ではArgonが上回る項目も、GPT-6 AstraやClaude Opus 5.5が上回る項目もあります。使いたい作業で判断しましょう。
「高値」は高い料金プランですか?
添付画面では「思考レベル」内の表示です。料金プランの名称ではありません。ただし、推論量は処理時間やAPIの費用に影響し得ます。
100万トークンをチャットで一度に出力できますか?
APIのLong Decodeに関する上限を、通常チャットの出力保証として使うことはできません。入力・推論・出力は共通の枠を消費します。
Argonを検討するときは、自分の仕事で必要な精度・待ち時間・確認の手間を見ることが大切です。今回の画面は操作や回答形式の参考に、比較表は得意分野を探す材料として使ってください。
公式出典・参考リンク
情報確認日:2026年10月14日。仕様・料金・提供範囲は変更される場合があります。画面4枚は提供されたスクリーンショットです。